Rust の型
分類#
- 大きく分けて2つ
- プリミティブ型(primitive type):言語組み込みの型
- ユーザー定義型(user defined type)
- 更に、以下の2つに分かれる
- スカラ型(scalar type)
- 内部構造を持たない
bool,f64,u32等
- 複合型(compound type)
- 他の型を組み合わせて形成
- アクセスできる内部構造を持つ
- 例:
Vec<u32>,[u32],Student(自分で定義)
- スカラ型(scalar type)
プリミティブ型#
スカラ型#
ユニット型(unit type)#
- 空を表す型
- 唯一の値
(): からのタプル(=ユニット値)を持つ - 型は
unitではなく、()と書く - 値を返さない関数の戻り値はユニット型
- サイズは 0 バイト
- K-V のペアを格納するマップのようなデータ構造でキーだけ渡したいとき、値をユニット型にするとムダなメモリを使わずに済む
真理値型(bool type)#
trueかfalse
固定精度の整数#
iXX: 符号付き整数型(integer)uXX: 符号なし整数型(unsigned integer)指定可能なビット幅は 8, 16, 32, 64, 128
- アーキテクチャなど、環境に依存しない
- 128 のみ、 Rust 1.26.0 以前で使用できない
アドレス幅指定の整数型は
isize(符号付き) かusize(符号なし)- CPU のメモリアドレスのビット幅によって決定
整数リテラルはデフォルトでは
i32と解釈される型を指定したいときはサフィックスで型名を付与
以下のような場合、型推論が働く
- 2行目で
n2は一見i32になるように見えるが、3行目でisizeと加算しているため、n2はisizeとなる。
- 2行目で
プレフィックスとして
0x,0o,0bをつけると、それぞれ16進数、8進数、2進数として解釈される以下のように書くと、 ASCII 文字に対応する文字コードが得られる
- 型はデフォルトで
u8
- 型はデフォルトで
整数演算は以下の通り
- べき乗をやりたいときは、
pow()メソッドを使う - インクリメント、デクリメントや三項演算子はない
- べき乗をやりたいときは、
固定精度の浮動小数点数#
f32とf64- デフォルトで
f64 - サフィックスで型を指定可能
578.6E+77のように、指数部も指定可能
文字型#
charリテラルはシングルクォートで作れる- 英数字であっても 4 バイト使用する
- Unicode で文字を表すコードポイントを
U+16進数で表す - 表示上1文字でも、複数のコードポイントを組み合わせて作られる文字(絵文字など)で
charリテラルを作ろうとすると、コンパイルエラーになる
参照型(reference type)#
- メモリ安全なポインタ
- 参照は、ポインタで指したい値に
&や&mutをつけることで作成できる。 - 型は
&Tや&mut Tのように表す&T: イミュータブルな参照(不変の参照)・・・参照先の値の読み出しだけが可能&mut T: ミュータブルな参照・・・参照先の値の読み出しと書き込みの両方が可能
- 参照外し:ポインタの先頭に `` をつける
- ポインタが指す値を取り出したり、ポインタが指す値を変更するとき
生ポインタ型(raw pointer type)#
- メモリ安全ではないポインタ
- 不変の生ポインタは
const T型, 可変の生ポインタはmut T型になる - 使い所は、ポインタを他の言語との間で受け渡したり、所有権システムの管理から外したいとき
- 安全性を保証しないため、参照外しや外のポインタ型への変換は
unsafeブロックで囲む必要がある
関数ポインタ型(fn pointer type)#
- 関数を表すポインタ
- 例:
fn double(n: i32) -> i32を指す関数ポインタはfn(i32) -> i32と表記する
- 例:
- サイズは
usize型と同じ
プリミティブな複合型#
タプル型(tuple type)#
(88, true)や(0.0, -1.0, 1.0)のようにカンマで区切った要素の組をもつ。各要素の型は異なっていても構わない。
要素へのアクセスは、 0 始まりの要素番号で
- フィールド名には定数のみ使える。変数を入れるとコンパイルエラー。
要素を書き換えるためには、タプルに
mutをつけて可変にするパターンマッチで分解して参照も可能
 1// 要素を書き換えるので、変数t1に`mut`を付けて可変にする
 2let mut t1 = (88, true);
 3// フィールド0の要素を書き換える
 4t1.0 += 100;  // 現在の値に100を足す
 5assert_eq!(t1, (188, true));
 6
 7// 不要な値はアンダースコアを使うと無視できる
 8#[allow(unused_variables)]
 9let ((x1, y1), _) = ((0, 5), (10, -1));
10
11// 要素を書き換えるので、変数t1に`mut`を付けて可変にする
12let mut t1 = ((0, 5), (10, -1));
13
14// 要素を指す可変の参照を得るためにref mutを追加する
15let ((ref mut x1_ptr, ref mut y1_ptr), _) = t1;
16
17// *を付けることでポインタが指すアドレスにあるデータにアクセスできる
18*x1_ptr += 3;
19*y1_ptr *= -1;
20
21assert_eq!(t1, ((3, -5), (10, -1)));
配列型(array type)#
- 0 から始まる
- 配列の型は、要素の型と長さで表す:
[bool; 3],[f64; 4]など - 配列の長さはコンパイル時に決まる
- 実行時に長さを決めたい場合は、ベクタ(
Vec<T>型)を使う
- 実行時に長さを決めたい場合は、ベクタ(
- 要素へのアクセスは、インデックスかイテレータで
- get() メソッドでより安全に(パニックせずに)取り出せる
- 値がある特は、
Some(& 値), 無いときはNoneを返す
- 値がある特は、
- 配列に使える
len(),get(),iter()は配列自体に備わっているのではなく、スライスに備わっているもの- array のドキュメントには載っておらず、 slice のページを見ないと説明がない
- 詳しくは、型強制のところで。
スライス型(slice type)#
配列要素の範囲に効率よくアクセスするためのビュー
- 配列だけでなく、連続したメモリ領域に同じ型の要素が並んでいるデータ構造なら、どれでも対象にできる
- ベクタや Rust 以外の言語で作成された配列も含む
スライスには、不変・可変の参照か
Boxというポインタの一種を経由してアクセスする。- そのため、型は
&[bool],&mut [bool],Box<[bool]>のように表記する
- そのため、型は
スライスの長さはコンパイル時ではなく、実行時に決まる
1// この関数は&[char]型のスライスを引数に取り、その情報を表示する 2fn print_info(name: &str, sl: &[char]) { 3 println!( 4 " {:9} - {}, {:?}, {:?}, {:?}", 5 name, 6 sl.len(), // 長さ(バイト数) usize型 7 sl.first(), // 最初の要素 Option<char>型 8 sl[1], // 2番目の要素 char型 9 sl.last() // 最後の要素 Option<char>型 10 ); 11} 12 13fn main() { 14 // 配列 15 let a1 = ['a', 'b', 'c', 'd']; // 参照元のデータ。[char; 4]型 16 println!("a1: {:?}", a1); 17 18 print_info("&a1[..]", &a1[..]); // &[char]型。全要素のスライス 19 print_info("&a1", &a1); // 同上 20 print_info("&a1[1..3]", &a1[1..3]); // 'b'と'c'を要素とする長さ2のスライス 21 22 // ベクタ 23 let v1 = vec!['e', 'f', 'g', 'h']; // 参照元のデータ。Vec<char>型 24 println!("\\nv1: {:?}", v1); 25 26 print_info("&v1[..]", &v1[..]); // &[char]型。全要素のスライス 27 print_info("&v1", &v1); // 同上 28 print_info("&v1[1..3]", &v1[1..3]); // &[char]型。'f'と'g'を要素とする長さ2のスライス 29}&a1[1..3]と書いたときに、インデックス 3 の要素が含まれないことに注意- Rust では、
begin..endで範囲を指定した際、 begin は含むが、 end は含まない - end を含めたい場合は、
begin..=endを使う
- Rust では、
配列
a1に対して、&a1[1..3]:不変のスライス&mut a1[1..3]:可変のスライス
&[T]や&mut[T]といった一般的なスライスは、ポインタの一種なので、それ自身は値を持たない。- Rust で「データを所有せず、借用している」と呼ぶ状態
ボックス化されたスライス
Box<T>という型は、データを所有する- ヒープ領域にデータを削除
- ライフタイムが尽きるとデータは削除される
文字列スライス#
str型は、 Unicode の文字で構成された文字列- 殆どの場合、
strにはスライスを通じてアクセスされる len()は文字数ではなく、 UTF-8 のバイト数を返す点に注意&strは不変スライス経由のアクセス、&mut strは可変スライス経由のアクセス- ただし、可変スライス経由でも、要素の追加や削除はできない(UTF-8バイト列の要素変更はできる)
- 文字列の内容を自由に変更するには、 String 型を使う
ユーザー定義型#
メモリ領域について#
以下の表のような4領域にメモリ上を分ける
- スタックは高速な反面、領域は大きくない -> 使いすぎると、スタックオーバーフローが発生
- ヒープは遅い。必要なときに確保と開放が行われる。領域は大きめ。
領域 リンカで用いられる名称 用途 プログラム領域 text プログラムのマシンコードが置かれる 静的領域(static 領域) data, bss プログラム起動時に確保され、グローバル変数や文字数リテラルなどが置かれる スタック領域 stack 関数の引数やローカル変数が置かれる ヒープ領域 heap 動的に確保され、プログラム内で共有されるデータが置かれる Rust では、デフォルトで値をスタックに置く
以下のような型は、データの一部をヒープに置く:
- Box ポインタ(
Box<T>) Vec<T>やHashMap<K, V>のように、要素数が可変のコレクション型の要素- String や OSString のような、文字列の追加や削除が可能な文字列の要素
- Box ポインタ(
標準ライブラリの主な型#
Box<T>#
メモリ安全なポインタ
対象のデータはヒープ領域に置く
ポインタだが、対象のデータを所有する
Box ポインタを作成する例が以下:
 1fn main() {
 2    let t1 = (3, "birds".to_string());  // (i32, String)型のタプル。スタックに置かれる
 3    let mut b1 = Box::new(t1);          // Boxポインタを作る。タプルがヒープに移動する
 4    (*b1).0 += 1;                       // *で参照外し
 5    assert_eq!(*b1, (4, "birds".to_string()));
 6
 7    // Box::new()の実行後にt1にアクセスしようとするとコンパイルエラーになる
 8    // println!("{:?}", t1);
 9    //   → error[E0382]: borrow of moved value: `t1`
10}
上記の
Box::new(t1);を実行する直前のメモリ状態を図にすると以下のようになる: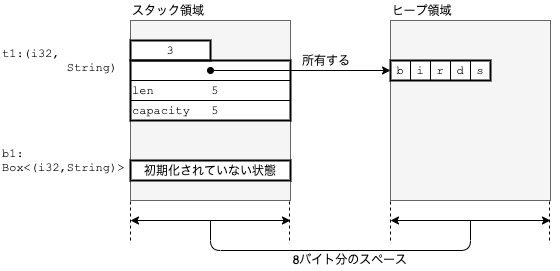
Box::newする直前のメモリ状態 - スタック領域に変数
t1とb1のためのスペースが用意されている。t1は(i32, String)のタプル。i32は 4 バイトのスペースに収まる。Stringは以下の 3 つのフィールドで構成(64 ビットの CPU なら 8 バイトずつ):- ヒープ領域の UTF-8 バイト列を指すポインタ
- 文字列の長さ(
len) - キャパシティ(
capacity):ヒープの再割当なしに格納できる要素数の最大値
b1はスペース確保済みだが、初期化されていない。
- スタック領域に変数
Box::new(t1);実行後は以下のようになる: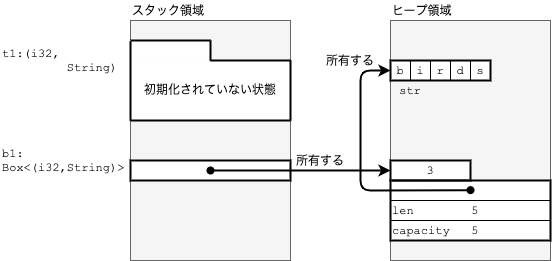
Box::newした直後のメモリ状態 (i32, String)型のタプルはヒープ領域に移動。b1がその位置を指している。t1はタプルに関する情報を所有しないこととなり、初期化されていない状態になる。- この状態で
t1にアクセスしようとするとコンパイルエラーとなる。
- この状態で
関数の実行が終了すると、
t1,b1ともにスタック領域のスペースが解放される。- Box ポインタの削除、それが所有していたヒープ上のタプルの削除、タプル内の
Stringが所有していた UTF-8 バイト列も削除
- Box ポインタの削除、それが所有していたヒープ上のタプルの削除、タプル内の
このあたり、所有権システムを理解した上でもう一度ちゃんとやる。
- Box ポインタの使い所:
- コンパイル時にデータサイズが決まらない型を使うとき
- 大きなデータをコピーすること無く、所有権を他へ移したい時
- トレイトオブジェクトを作成したい時 この点は追々。
ベクタ#
ベクタ
Vec<T>は配列を表現する型ベクタを初期化するときは
vec![]マクロを使う配列と同じく、同じ型の要素の並びでないといけない
ベクタの型は
Vec<要素の型>で表す。入れ子のものはVec<Vec<要素の型>>空のベクタを作るときは、
new()メソッドを使う。事前に大まかな要素数がわかっているときは、with_capacity(要素数)メソッドを使うと良い:メモリ再割当てのオーバーヘッドが削減できるため。配列
[T; n]やスライスとのメモリレイアウトの違いは以下の表と図:- ベクタとボックス化されたスライスは実データをヒープ領域に格納する
- 配列はスタック領域に格納する
- スタックのほうが高速なので、配列の方が有利だが、あまり大きなデータは入れられない
Box<T>はベクタから変換して作る- 要素数は実行時に決まる
- 実データはヒープ領域に格納
- 要素の追加と削除はできない
- スライスに用意されたメソッドだけ使える
Vec<T>は余分なメモリが確保されているshrink_to_fit()メソッドでメモリを削ぎ落とすことは可能
型 役割 実データを格納するメモリ領域 要素数決定のタイミング 要素の追加・削除の可否 実データを所有するか否か ベクタ Vec<T>サイズ可変の配列 ヒープ領域 実行時 ○ ○ 配列 [T; n]サイズ固定の配列 スタック領域 コンパイル時 × ○ ボックス化されたスライス Box<[T]>サイズ固定の配列 ヒープ領域 実行時 × ○ その他のスライス: &[T], &mut [T]ベクタや配列へのアクセスを抽象化 参照先に依存(ヒープ or スタック) 実行時 × × 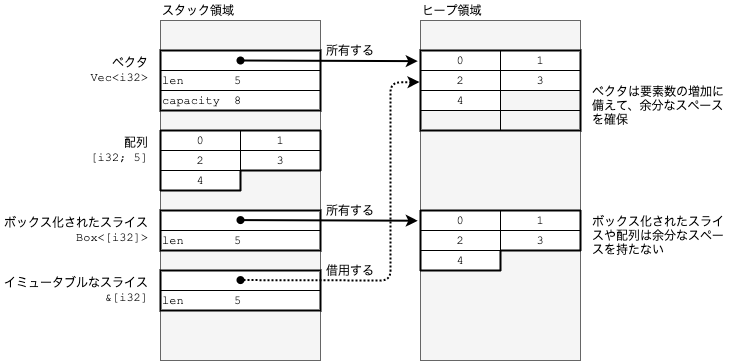
それぞれのメモリ領域の使い方の比較
その他のコレクション型#
- マップ:HashMap, BTreeMap
- セット:HashSet, BTreeSet
- キュー:VecDeque, BinaryHeap
- リスト:LinkedList
ハッシュアルゴリズムの性能#
- ハッシュ値の生成に SipHash という暗号強度のハッシュアルゴリズムを使用している
- hashdos という DoS 攻撃への耐性を確保している
- SipHash は暗号強度を持つアルゴリズムの中では高速な部類に入るが、ハッシュ値を求めるために多くの計算を必要とする
- 性能が悪いと感じた場合は、FNV のようなハッシュアルゴリズムの使用を検討する
String(std::string::String)#
&strとStringの関係は、不変のスライスとベクタの関係に似ているStringは文字の変更や追加や削除が可能&strは不変
実データは UTF-8 形式でエンコードされていて、ヒープに格納される
数値型などから
Stringを作るには、to_string()メソッドやformat!()マクロを使う文字列から数値型を作るには、
str型のparse()メソッドを使うバイト列から作成することも可能
 1fn main() {
 2    let i = 42;           // i32型
 3    assert_eq!(i.to_string(), "42");
 4
 5    let f = 4.3 + 0.1;    // f64型
 6    assert_eq!(f.to_string(),       "4.3999999999999995");
 7    assert_eq!(format!("{:.2}", f), "4.40");  // format!マクロが便利
 8
 9    let t = (1, "ABC");
10    // 2要素のタプル型はDebugトレイトを実装しているのでformat!マクロで変換できる
11    assert_eq!(format!("{:?}", t), r#"(1, "ABC")"#);
12
13    let s1 = "42";
14    assert_eq!(s1.parse::<i32>(), Ok(42)); // &str型からi32型へ変換
15
16    let s2 = "abc";
17    let r2: Result<f64, _> = s2.parse();   // 変数の型から型推論できるならparseの型パラメータは不要
18    assert!(r2.is_err());                  // 数値として解釈できないときはエラーが返る
19    println!("{:?}", r2);                  // → Err(ParseFloatError { kind: Invalid })
20
21    let cs = ['t', 'r', 'u', 's', 't'];      // [char; 5]型
22    assert_eq!(cs.iter().collect::<String>(),       "trust");
23    assert_eq!(&cs[1..].iter().collect::<String>(), "rust" );
24
25    let bad_utf8: [u8; 7] = [
26        b'a',              // a
27        0xf0, 0x90, 0x80,  // でたらめなバイト列
28        0xe3, 0x81, 0x82,  // あ
29    ];
30
31    // 不正なバイト列はUnicodeのU+FFFD Replacement Characterに置き換わる
32    let s = String::from_utf8_lossy(&bad_utf8);
33    assert_eq!(s, "a\\u{fffd}あ");
34}
String と &str の比較#
Stringは実データを所有する。&strは不変スライスで、実データを所有せずに借用している。- 文字列リテラルから作成した場合:実データは静的領域に置かれる
- String から作成した場合:String がヒープ領域に置いてある実データを参照する
- バイト列から作成した場合:ヒープまたはスタック領域に置かれているバイト列を実データとして参照する
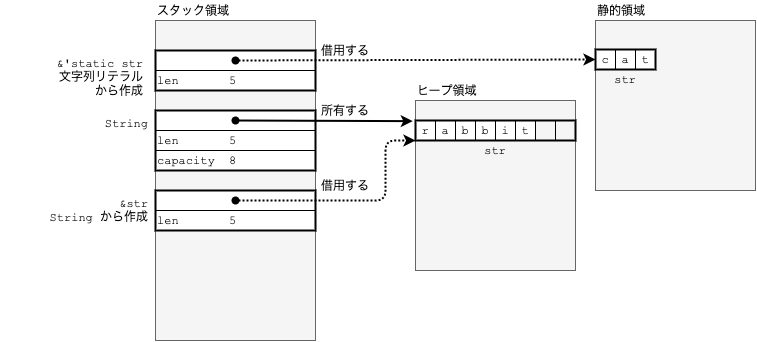
Stringと&strのメモリの使い方の違い 関数の引数として文字列を作るときは、文字列が不変で構わないなら、コストの低い
&strにすべき- 可変でないと困るなら、
&mut String, 所有権も必要ならString
- 可変でないと困るなら、
&strは参照先の UTF-8 バイト列よりも短い期間しか生存できない- 関数から返すときは注意が必要
 1// この関数は引数として&str型の名前を取り、&str型の"Hello, 名前!"を返す
 2// fn f1(name: &str) -> &str {
 3//     let s = format!("Hello, {}!", name); // format!はStringを作る
 4//     &s   // Stringから&strを作成し、戻り値として返す
 5//     // → コンパイルエラー:`s` does not live long enough.(sの生存期間が不十分)
 6// }
 7
 8// この関数は引数として&str型の名前を取り、String型の"Hello, 名前!"を返す
 9fn f1(name: &str) -> String {
10    format!("Hello, {}!", name)
11}
12
13fn main() {
14    f1("ken");
15}
上のコードでエラーになるところは、
format!で新たに作った String が関数を抜けるときにライフタイムが尽きて、削除されることが原因- コンパイラが、バイト列にアクセスできなくなることを検出する
範囲(Range)#
start..end,start..=end,start..,..endのような形をとって、数列の作成やスライスの範囲指定などに使われる6つの構文がそれぞれ別の型に対応している
- 6つの
Range*型に対応するジェネリクスな関数を定義するには、RangeBoundsトレイトを使う。
1fn main() { 2 let a = ['a', 'b', 'c', 'd', 'e']; 3 4 assert_eq!(a[ .. ], ['a', 'b', 'c', 'd', 'e'] ); 5 assert_eq!( .. , std::ops::RangeFull ); 6 7 assert_eq!(a[ .. 3], ['a', 'b', 'c', ] ); 8 assert_eq!( .. 3 , std::ops::RangeTo { end: 3 } ); 9 10 assert_eq!(a[ ..=3], ['a', 'b', 'c', 'd' ] ); 11 assert_eq!( ..=3 , std::ops::RangeToInclusive { end: 3 } ); 12 13 assert_eq!(a[1.. ], [ 'b', 'c', 'd', 'e'] ); 14 assert_eq!( 1.. , std::ops::RangeFrom { start: 1 } ); 15 16 assert_eq!(a[1.. 3], [ 'b', 'c' ] ); 17 assert_eq!( 1.. 3 , std::ops::Range { start: 1, end: 3 } ); 18 19 assert_eq!(a[1..=3], [ 'b', 'c', 'd' ] ); 20 assert_eq!( 1..=3 , std::ops::RangeInclusive::new(1, 3) ); 21}- 6つの
オプション(Option)#
値があるかどうかがわからないことを表す型
- 値があるときは
Some(値), 無いときはNoneを使う
- 値があるときは
オプションの値が
Some(値)かNoneかを調べるときには、matchやif letを使う。Someから値をアンラップ(開封)するには、unwrap()メソッドを使う:ただし、Noneのときにpanicするので、できるだけ使わないほうが良いunwrap_or_else()ならNoneでもpanicしない
 1let mut o2 = Some(String::from("Hello"));  // Option<String>型
 2assert_eq!(o2.unwrap(), "Hello");          // unwrap()でSomeの中の値が取り出せる
 3
 4// しかしunwrap()はNoneのときにpanicするので、できるだけ使わない方がいい
 5o2 = None;
 6// o2.unwrap();
 7// → thread 'main' panicked at 'called `Option::unwrap()` on a `None` value'
 8
 9// unwrap_or_else()ならNoneでもpanicしないので安心して使える
10// Noneのときはクロージャを実行し、Noneの代わりになる値を得る
11assert_eq!(o2.unwrap_or_else(|| String::from("o2 is none")), "o2 is none");
アンラップするのではなく、
Someで包まれたまま中の値を加工するときは、map()やand_then()といったコンビネータ・メソッドが使える1// Someで包まれた値を操作するならmap()やand_then()などのコンビネータが便利 2// map()はSome(値)のときは値にクロージャを適用し、クロージャが返した値をSomeで包み直す 3let mut o3 = Some(25); 4assert_eq!(o3.map(|n| n * 10), Some(250)); 5 6// NoneならなにもせずNoneを返す 7o3 = None; 8assert_eq!(o3.map(|n| n * 10), None); 9 10o3 = Some(10); 11assert_eq!( 12 o3.map(|n| n * 10) 13 // and_then()はSome(値)のときは値にクロージャを適用し 14 // クロージャが返した値(Some(新しい値)、または、None)をそのまま返す 15 .and_then(|n| if n >= 200 { Some(n) } else { None }), 16 None 17);複数の
Option値を扱うときは、?演算子が使える1fn add_elems(s: &[i32]) -> Option<i32> { 2 // 複数のOption値を扱うときは?演算子が便利 3 // Some(値)なら値を取り出し、Noneならこの関数からすぐに戻る(Noneを返す) 4 let s0 = s.get(0)?; 5 let s3 = s.get(3)?; 6 Some(s0 + s3) 7} 8 9// インデックス0と3の両方に値があるので、それらの合計がSomeで包まれて返される 10assert_eq!(add_elems(&[3, 7, 31, 127]), Some(3 + 127)); 11 12// インデックス3がないのでNoneが返される 13assert_eq!(add_elems(&[7, 11]), None);
リザルト(Result)#
Result<T, E>は処理の結果はエラーになる可能性を暗示する型- 列挙型として定義されており、
OK(T 型の結果を示す値)とErr(E 型のエラーを示す値)の 2 つのバリアントを持つ
- 列挙型として定義されており、
オプションと同様に、複数のリザルト値を扱うときは、
?演算子を使うと良いリザルト型にも
map(),and_then(),or_else()が定義されている1fn main() { 2 // str::parse()は文字列を指定した型(ここではi32型)に変換する 3 assert_eq!("10".parse::<i32>(), Ok(10)); // 変換できたらOK(値)が返される 4 let res0 = "a".parse::<i32>(); // 変換できなかったら`Err(エラーを表す値)`が返される 5 assert!(res0.is_err()); 6 println!("{:?}", res0); // → Err(ParseIntError { kind: InvalidDigit }) 7 8 // 複数のResult値を扱うときは?演算子が便利 9 // Ok(値)なら値を取り出し、Err(エラーを表す値)ならこの関数からリターンする 10 fn add0(s0: &str, s1: &str) -> Result<i32, std::num::ParseIntError> { 11 let s0 = s0.parse::<i32>()?; 12 let s1 = s1.parse::<i32>()?; 13 Ok(s0 + s1) 14 } 15 16 assert_eq!(add0("3", "127"), Ok(3 + 127)); 17 assert!(add0("3", "abc").is_err()); 18 19 // map_err()コンビネータを使うとErr(エラーを表す値)のときに別のエラーに変換できる 20 fn add1(s0: &str, s1: &str) -> Result<i32, String> { 21 let s0 = s0.parse::<i32>().map_err(|_e| "s0が整数ではありません")?; 22 let s1 = s1.parse::<i32>().map_err(|_e| "s1が整数ではありません")?; 23 Ok(s0 + s1) 24 } 25 26 assert_eq!(add1("3", "abc"), Err("s1が整数ではありません".to_string())); 27}
標準ライブラリのエラーの使い所#
- ライブラリを開発した場合、標準ライブラリのエラー型を返さないほうが良い
- 独自のエラー型を定義し、それに変換してから返すほうが良い
- 独自のエラーを定義する際は、
std::convert::Fromトレイトを実装するのが良い?演算子が関数の戻り値に合うようにエラーを変換してくれる- いちいち
map_err()で変換する必要がなくなる
独自エラーの作り方例#
thiserrorを用いて実装するのが良い- ちょうど良い記事: Rust エラー処理2020 - 電気ひつじ牧場
新しい型の定義方法と型エイリアス#
型エイリアス#
型エイリアスは、型につけられる別名
typeキーワードで定義するコンパイラは型エイリアスを元の型と同じものとして扱う
あくまで別名なので、以下のような間違いをしてもコンパイルエラーにはならない:
idもnowもi64型であるため
1let bad_user = new_user(String::from("mika"), now, id);型のネストが深くなったときに使うと見通しが良くなる
- 例:多くの関数では、
result<T, std::io::Error>をstd::io::Result<T>として定義している
- 例:多くの関数では、
構造体(struct)#
3種類の構造体:
- 名前付きフィールド構造体
- タプル構造体
- ユニット構造体
名前付きフィールド構造体には、関数型レコードアップデート構文(functional record update syntax)と呼ばれる構文がある
- これにより、すでにある値をもとにしてその一部を使った新しい値を作ることができる。
構造体に対して
Defaultトレイトを実装すると、デフォルト値を設定できる1// #[derive(Default)] 2struct Polygon { 3 vertexes: Vec<(i32, i32)>, 4 stroke_width: u8, 5 fill: (u8, u8, u8), 6} 7 8#[allow(unused_variables)] 9let polygon1: Polygon = Default::default(); 10 11// vertexesフィールドだけ別の値に設定し、他はデフォルト値にする 12#[allow(unused_variables)] 13let polygon2 = Polygon { 14 vertexes: vec![(0, 0), (3, 0), (2, 2)], 15 .. Default::default() 16};タプル構造体は、フィールドの名前を与えずに 0 から始まる連番のフィールド名を用いる
デザインパターン「newtype」:型エイリアスの代わりにフィールドが一つのタプル構造体を定義することで、コンパイラ型のチェックを強化する
enum: 列挙型#
Enum の定義の仕方:https://doc.rust-jp.rs/book-ja/ch06-01-defining-an-enum.html
 1#[derive(Debug, PartialEq)]
 2enum Weekday {
 3    // Weekday型には以下のバリアントがある。
 4    Monday, Tuesday, Wednesday, Thursday, Friday,
 5}
 6
 7// 月を表すMonth型を定義する
 8#[allow(dead_code)]
 9enum Month {
10    // バリアントにisize型の整数値を割り当てられる
11    January = 1, February = 2, March = 3, /* 中略 */  December = 12,
12}
13
14#[allow(dead_code)]
15#[derive(Debug)]
16enum Task {
17    Open,
18    AssignedTo(UserName),
19    Working {
20        assignee: UserName,
21        remaining_hours: u16,
22    },
23    Done,
24}
25
26fn main() {
27    // Task型の値を3つ作り、ベクタに格納する
28    let tasks = vec![
29        // もし上のuse宣言がなかったらTask::AssignedToと書かないといけない
30        AssignedTo(String::from("junko")),
31        Working {
32            assignee: String::from("hiro"),
33            remaining_hours: 18,
34        },
35        Done,
36    ];
37}
実践的な情報#
フィールドの可視性#
- 構造体や列挙体の可視性はデフォルトで private なため、他のモジュールからはアクセスできない。
- モジュール外からアクセスできるようにするには、
pubキーワードを追加する- 構造体の場合、構造体自体だけでなく、フィールドごとの可視性も制御できる
- 列挙体の場合、列挙体自体の可視性だけが制御できる
- 列挙体自体を
pubに設定したら、バリアントやバリアントが持つフィールドもpubになる
- 列挙体自体を
フィールドに参照をもたせる#
構造体や列挙体のフィールドに参照をもたせる場合、ライフタイム指定子という所有権に関する情報を明示せねばならない
ジェネリクス#
ジェネリクスな関数の例
1pub fn sort<T: Ord>(x: &mut [T], up: bool) {...}構造体や列挙型もジェネリクスにすることが可能
 1#[derive(Default)]
 2pub struct Polygon<T> {
 3	pub vertexes: Vec<T>,
 4	...
 5}
 6
 7// 座標一般
 8trait Coordinates {}
 9
10// デカルト座標
11#[derive(Default)]
12struct CaritesianCoord {
13	x: f64,
14	y: f64,
15}
16impl Coordinates for CartesianCoord {}
17
18// 極座標
19#[derive(Default)]
20struct PolarCoord {
21	r: f64,
22	theta: f64,
23}
24impl Coordinates for PolarCoord {}
25
26let vertexes = vec![
27	CartesianCoord {x: 0.0, y: 0.0},
28	CartesianCoord {x: 50.0, y: 0.0},
29	CartesianCoord {x: 30.0, y: 20.0},
30]
31
32// Polygon<CartesianCoord>型
33let poly = Polygon { vertexes, ..., Default::default() };
内部表現と repr(C)#
構造体がメモリにどのように格納するかは、以下のコードを実行することで表示される
FFI を通じて他の言語に構造体を渡したり受け取ったりするときには、メモリの内部構造がわかっていないと困る場面もある
型変換#
- ある型を別の型へと変換する方法がいくつか用意されている
- 型キャスト(type cast)
as型を利用した明示的な型変換- データ変換を伴い、スカラ型同士を変換できる
- Transmute
- コンパイラ・イントリンシック(組み込み命令)である
std::mem::transmuteを使用した明示的かつアンセーフな型変換。 - データ変換を伴わない。
- コンパイラ・イントリンシック(組み込み命令)である
- 型強制(type coercion)
- コンパイラによる暗黙的な型変換。
- データ変換を伴う。
- 型キャスト(type cast)
型キャスト#
as型を利用した明示的な型変換- データ変換を伴い、スカラ型同士を変換できる
- タプルや配列のような複合型の変換には使えない
- 型キャストでは、桁あふれはチェックしないことに注意
- 複合型のときは、要素1つ1つをキャストしていく
- 一部の複合型の変換は、
From::from()で実現できる
Trasmute#
- コンパイラ・イントリンシック(組み込み命令)
std::mem::transmuteを利用した、明示的かつアンセーフな型変換- メモリ上の表現(ビット列)のサイズさえ同じなら、どんな型同士でも変換できる
- データ変換を伴わない
型強制#
- コンパイラによる暗黙的な型変換
- データ変換を伴う
- 型強制が行われる場所は以下:
let,static,const文- 関数の引数
- 構造体やバリアントのフィールドへの値の設定
- タプルリテラル
- 配列のリテラル
- 関数の戻り値
- 型強制の種類
- Deref による型強制
Derefトレイトを実装しているときに可能
- ポインタの弱体化
- あるポインタ型を機能がより制限されたポインタ型に型強制できるルール
- サイズの不定化
- 環境画からのクロージャ → 関数ポインタ型
- ! → 任意の型
- Deref による型強制
基本構文#
メソッドはインスタンスに紐付いたもの、第一引数が
&self, 関連関数は、 static 関数みたいなもの変数と値を結びつけることを Rust では、「変数を値に束縛する」と表現する
ここに掲載する記事はまだありません。